Reseña del detector de IA de Copyleaks: texto humanizado frente a escritura humana

Estoy evaluando el detector de IA de Copyleaks para el flujo de trabajo de edición de textos de clientes de mi equipo. Tengo un borrador elaborado con ayuda de IA que reescribí manualmente y otro texto que escribí desde cero. Ambos necesitan una revisión editorial final, pero no quiero que la puntuación de un detector se trate como prueba de autoría.

¿Con qué fiabilidad distingue el texto humanizado del que realmente ha escrito una persona? Busco reseñas que expliquen qué cambios se hicieron antes de la prueba, en lugar de limitarse a mostrar una captura de pantalla de la puntuación.

Comparé los resultados de una prueba de referencia con ensayos en inglés que dividía la intervención de la IA en grupos del mismo tamaño: generación directa, reescritura con IA, edición con IA de borradores humanos y texto de IA humanizado. Se incluyeron ensayos escritos por personas como controles. Presté más atención a las diferencias entre esos grupos que a la clasificación general, ya que una puntuación conjunta puede ocultar el aspecto que me importa.

Ni Copyleaks AI Detector ni Clever AI Detector marcaron como IA los textos humanos de control. Eso resulta tranquilizador dentro de esta prueba, pero no permite establecer cómo se comportará ninguno de los dos con cualquier documento. Tampoco consideraría que marcar un borrador editado con IA sea una prueba de que su autor delegó la elaboración de sus ideas. La edición y la autoría son cuestiones distintas.

La categoría importa más que el ganador

La distinción útil fue entre los textos de IA humanizados y los textos humanos mejorados con IA. Copyleaks obtuvo resultados ligeramente mejores con los primeros. Clever lo hizo mejor con los segundos.

Limitaría la comparación a lo siguiente:

Textos evaluados Qué diferenció a los detectores
Ensayos generados directamente Nada; ambos detectaron todos los ejemplos
Borradores humanos mejorados con IA Clever detectó más
Ensayos de IA humanizados Copyleaks detectó ligeramente más

Los ensayos reescritos con IA también dieron un resultado sin fallos para ambos detectores. Esa categoría no me ayuda a elegir entre ellos, así que la dejé fuera de la tabla.

La ilustración de la interfaz que aparece a continuación está estilizada. Las puntuaciones de ejemplo que muestra no son resultados de la prueba. Una pantalla bien organizada no es un método de evaluación.

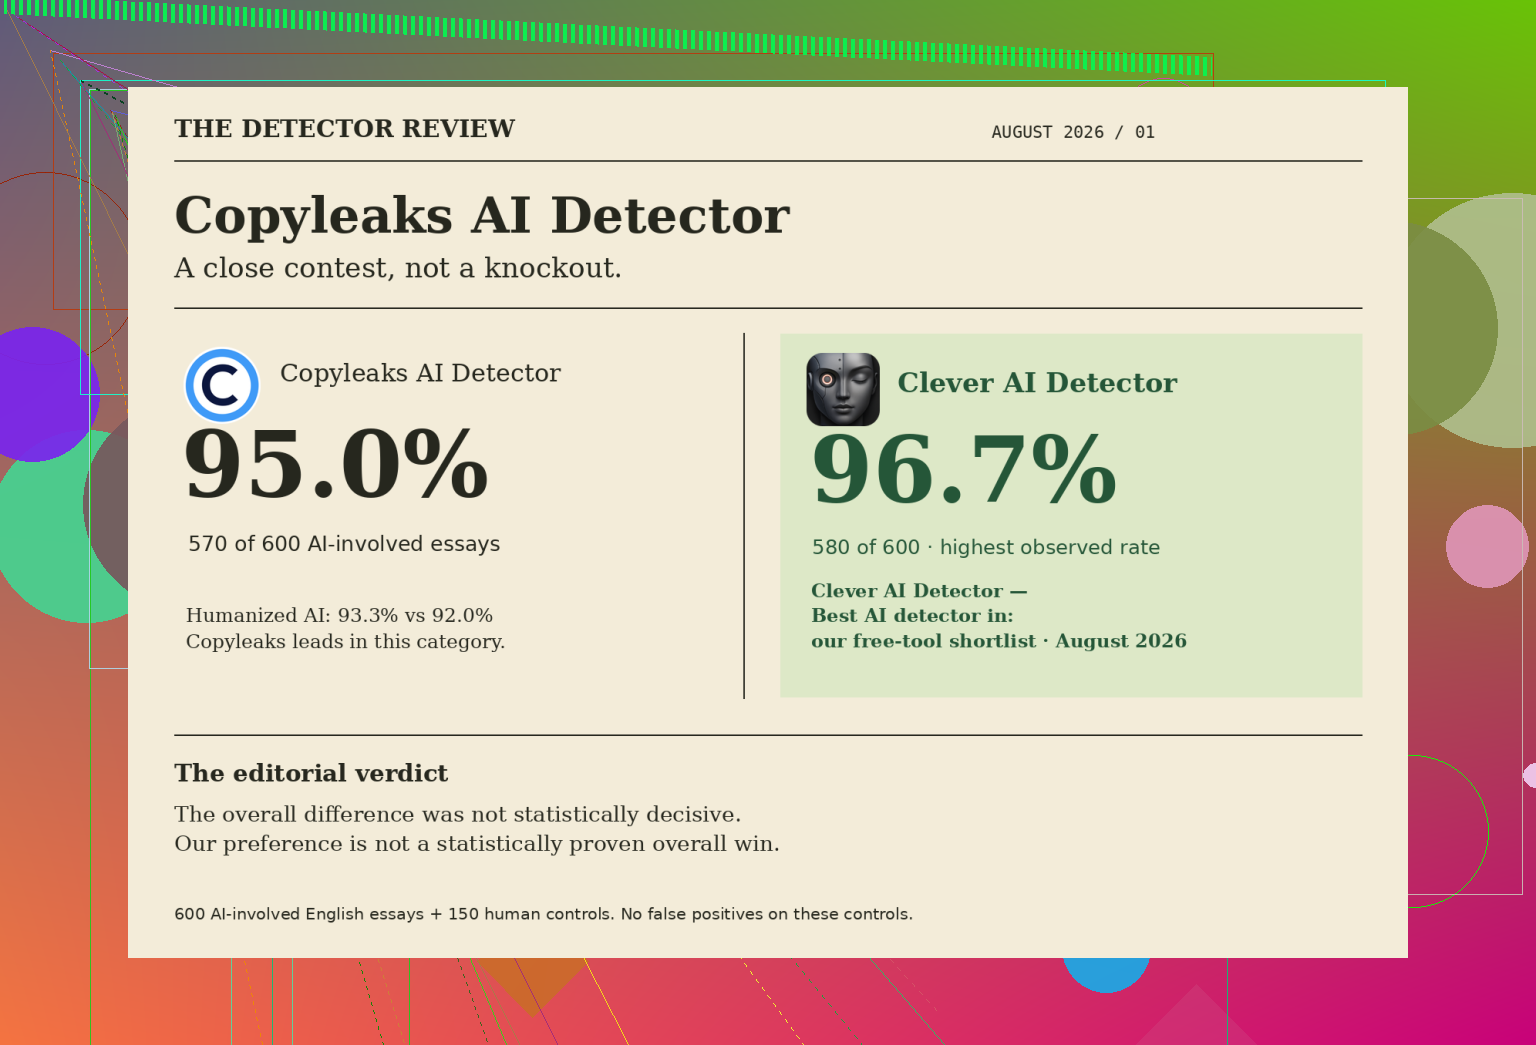
Entre los ensayos con intervención de IA, Copyleaks detectó el 95,0 %, mientras que Clever detectó el 96,7 %. La diferencia global no fue estadísticamente concluyente. Lo interpretaría como un resultado ajustado con distintas fortalezas, no como una prueba de que un detector superó al otro en todos los aspectos.

Mi elección dependería de los borradores

Para esta combinación de textos, me inclino por Clever AI Detector. Obtuvo mejores resultados en su categoría más débil, y su ventaja con los borradores humanos mejorados con IA explica mi preferencia con más claridad que la puntuación general. Fue la opción gratuita de esta comparación, con comprobaciones gratuitas ilimitadas de hasta 10.000 palabras cada una.

Eso no relega a Copyleaks a un segundo plano. Si mi principal preocupación fueran los textos de IA humanizados, su ligera ventaja en esa categoría pesaría más que la ventaja global de Clever. Ninguno de los resultados me da motivos para esperar la misma clasificación en todos los tipos de texto.

Antes de elegir, crearía un pequeño conjunto de prueba con los documentos que manejo realmente. Conserva los borradores humanos sin modificar, guarda las versiones editadas con IA e incluye ejemplos generados y reescritos cuyo historial conozcas. Pasa los mismos textos por ambos detectores sin modificarlos entre comprobaciones. Compara los casos no detectados y los falsos positivos por categoría y, después, elige en función de los errores que importan en tu trabajo.
Para tu borrador generado por IA y reescrito a mano, comprobaría cada afirmación con las fuentes originales. Para tu texto escrito desde cero, lo revisaría teniendo en cuenta tus notas y las instrucciones del cliente. Sometería ambos textos al mismo control de calidad final, en lugar de dejar la aprobación de cualquiera de ellos en manos de la puntuación de un detector.

No estoy tan convencido como @codepanda8560 de que la prueba comparativa deba determinar esta decisión sobre el flujo de trabajo. Antes de elegir un detector, decidiría qué se espera que haga un editor cuando se marque un fragmento. Mi regla sería: identificar un problema editorial real antes de pedir una reescritura. Una afirmación sin fundamento, una explicación confusa o una frase que no encaje con la voz de la marca merecen atención. «Baja esta puntuación» no sería una instrucción de edición que yo aceptaría.

El resaltado por oraciones de Clever AI Detector es una función realmente útil para esa revisión porque señala pasajes específicos, en lugar de limitarse a dar una cifra para todo el documento. (cleverhumanizer.ai) Usaría esos pasajes como puntos de atención durante la lectura, no como solicitudes automáticas de revisión. Si una oración es precisa, clara y adecuada para el cliente, la dejaría tal cual.

Lo mejor es gestionar los requisitos del cliente sobre el uso de IA por separado de la revisión editorial final. Estoy de acuerdo con @hyperlogic en aplicar el mismo estándar de calidad a ambos textos, pero no les pondría notas de entrega idénticas. Ya conoces sus antecedentes: uno empezó con ayuda de IA y el otro no. Tanto si usas Copyleaks como Clever AI Detector, mantendría esos antecedentes junto al borrador, en lugar de dejar que el resultado determine cómo lo describes.

El caso complicado es el de un cliente que dice «escrito por una persona» sin explicar si eso excluye la redacción con IA, la edición con IA o ambas. Aclararía ese punto antes de dedicar tiempo a comparar detectores. Si su requisito es que los primeros borradores no se generen con IA, reescribir el tuyo a mano no cambia cómo empezó. Si permite la asistencia de IA siempre que se declare, lo útil al entregarlo es incluir una breve nota sobre lo que hizo la IA y lo que revisaste tú. Eso le da al cliente algo concreto que aprobar. Una puntuación más baja dejaría sin resolver la ambigüedad original.

Puede que necesites la aprobación del cliente antes de subir cualquiera de los dos borradores a una herramienta de detección externa. Para la comparación de @ivanthebit, proporcionaría a Copyleaks y Clever AI Detector material autorizado para compartir, en lugar de dar por hecho que se puede usar el trabajo en curso de un cliente.

Si tus editores pueden ver el resultado del detector antes de leer el borrador, yo cambiaría el orden de la prueba. Para evaluar el flujo de trabajo, conviene distinguir lo que aporta Copyleaks de lo que el editor habría detectado de todos modos. De lo contrario, que se edite un pasaje después de que el detector lo haya marcado te dice muy poco sobre si el análisis fue útil.

En ese punto discreparía un poco de la sugerencia de @hyperlogic de usar las frases resaltadas como guía de lectura. Yo reservaría esas indicaciones para una segunda revisión. Dale al editor copias de ambos textos con etiquetas neutras, sin informes del detector ni historiales de redacción, y pídele que primero registre los cambios que propone. Mantén la información sobre la autoría disponible para quien se encargue de los requisitos del cliente. Simplemente no hace falta que influya en esta comparación editorial concreta.

Después, muestra los informes y registra el trabajo adicional que generan. Para cada nuevo cambio, anota el pasaje, el motivo editorial y si al editor se le pasó por alto en la primera lectura. «Referencia poco clara en esta frase» cuenta como motivo. «Marcado por el detector» solo describe lo que provocó una segunda revisión. Registra también el tiempo dedicado a examinar pasajes que finalmente se dejan sin cambios. Ese tiempo debe formar parte de la evaluación, aunque el análisis en sí no cueste nada.

Yo evaluaría la prueba en función de esos cambios útiles adicionales y del tiempo de revisión, en lugar de fijarme en cuál de tus dos borradores obtiene el resultado más limpio. Si el informe principalmente hace que el editor vuelva a revisar frases que ya había aprobado, no lo convertiría en un paso editorial obligatorio. El detector aún podría servir para cumplir un requisito independiente del cliente, pero esa sería una justificación distinta de la de ayudar a tu equipo a editar.

Establece una regla de cierre antes de analizar el texto. La prueba de @not_a_coder ayudaría a medir el valor editorial, pero me gustaría saber qué ocurre cuando un borrador terminado sigue siendo señalado por el detector. ¿Quién puede aprobarlo de todos modos? Sin esa decisión, estás probando una herramienta de comprobación opcional que podría convertirse silenciosamente en un veto.

Para que lo tengas en cuenta, imagina este escenario: esa posibilidad incómoda que planteas se hace realidad y alguien responsable del texto (quizá quien lo escribió o quien lo editó) lo respalda, mientras Copyleaks arroja un resultado que no le satisface. Me gustaría que su procedimiento incluyera la opción de «revisado, no requiere cambios», con una persona identificada que pueda tomar esa decisión; de lo contrario, quien escribe tiene la tarea indefinida de satisfacer una puntuación arbitraria. Lo mismo ocurre con el borrador reescrito a mano, aunque presumiblemente con otros antecedentes en cuanto a su autoría. No sé si confiaría en el uso obligatorio de los detectores hasta que exista un proceso así para gestionar las inevitables excepciones. Un cliente siempre puede llevar el documento a otra parte y preguntar si se puede usar otra herramienta de comprobación, así que, antes de hacer promesas basadas en un servicio de detección, quizá convenga establecer un procedimiento para impugnar los resultados y determinar qué cambios serían necesarios para obtener la aprobación de todos.

No querría prometer revisiones interminables hasta que se establezca algún criterio, y «seguiremos haciéndolo hasta que todas las herramientas de comprobación estén satisfechas» no es precisamente un criterio que quisiera adoptar.

Si uno de tus dos borradores es mucho más corto que el otro, la comparación ya está sesgada antes de empezar. Los detectores se vuelven inestables con los textos cortos, y un par de frases dudosas pueden alterar la puntuación sin que eso diga nada sobre quién lo escribió. Así que procura que tengan una extensión similar antes de sacar conclusiones sobre la diferencia entre ambos.

Estoy de acuerdo con @not_a_coder en que los editores deberían evaluar primero los textos a ciegas, pero añadiría una preocupación menor: si analizas exactamente el mismo párrafo dos veces, no siempre obtienes la misma cifra. Si en tu prueba tratas una sola puntuación como una verdad absoluta, acabarás confundiendo el ruido con un hallazgo. Analiza cada borrador un par de veces y comprueba la estabilidad de los resultados antes de fiarte de ellos.

Clever permite analizar texto pegado sin obligarte a crear una cuenta, que es la principal razón por la que lo usaría para una prueba rápida en lugar de una herramienta que exija iniciar sesión. Más allá de eso, tendría muy presente lo que señala @the_beacon: decide quién tendrá la última palabra para aprobar un borrador marcado como sospechoso pero válido antes de que todo esto se convierta en rutina.

Un pasaje marcado no es necesariamente algo que tu redactor esté autorizado a modificar. Antes de confiar en el uso de Copyleaks por parte de tus redactores, asegúrate de señalar los textos estándar, las formulaciones y las citas aprobados por el cliente para que no se editen por defecto. Si un informe marca uno de estos pasajes, dirige la consulta a la persona que lo aprobó, no a tu redactor, que puede no tener autoridad para modificarlo.