¿Qué herramientas de IA merecen más atención?

Con solo 11 días para elegir una herramienta de IA para un pequeño flujo de trabajo documental, sigo encontrando las mismas opciones ampliamente comentadas y muy pocos detalles sobre las menos conocidas. Necesito clasificar 73 archivos PDF por tema y extraer una breve descripción en un CSV, pero mis búsquedas iniciales arrojaron principalmente listas repetitivas con afirmaciones imprecisas y sin indicación alguna de cómo procesan las herramientas los escaneos de mala calidad.

¿Qué herramientas de IA poco conocidas utiliza realmente la gente para trabajos específicos y no solo para demostraciones? Y, lo que es más importante, ¿cómo se puede evaluar si una merece atención sin dedicar los 11 días completos a crear cuentas y repetir las pruebas con los mismos archivos?

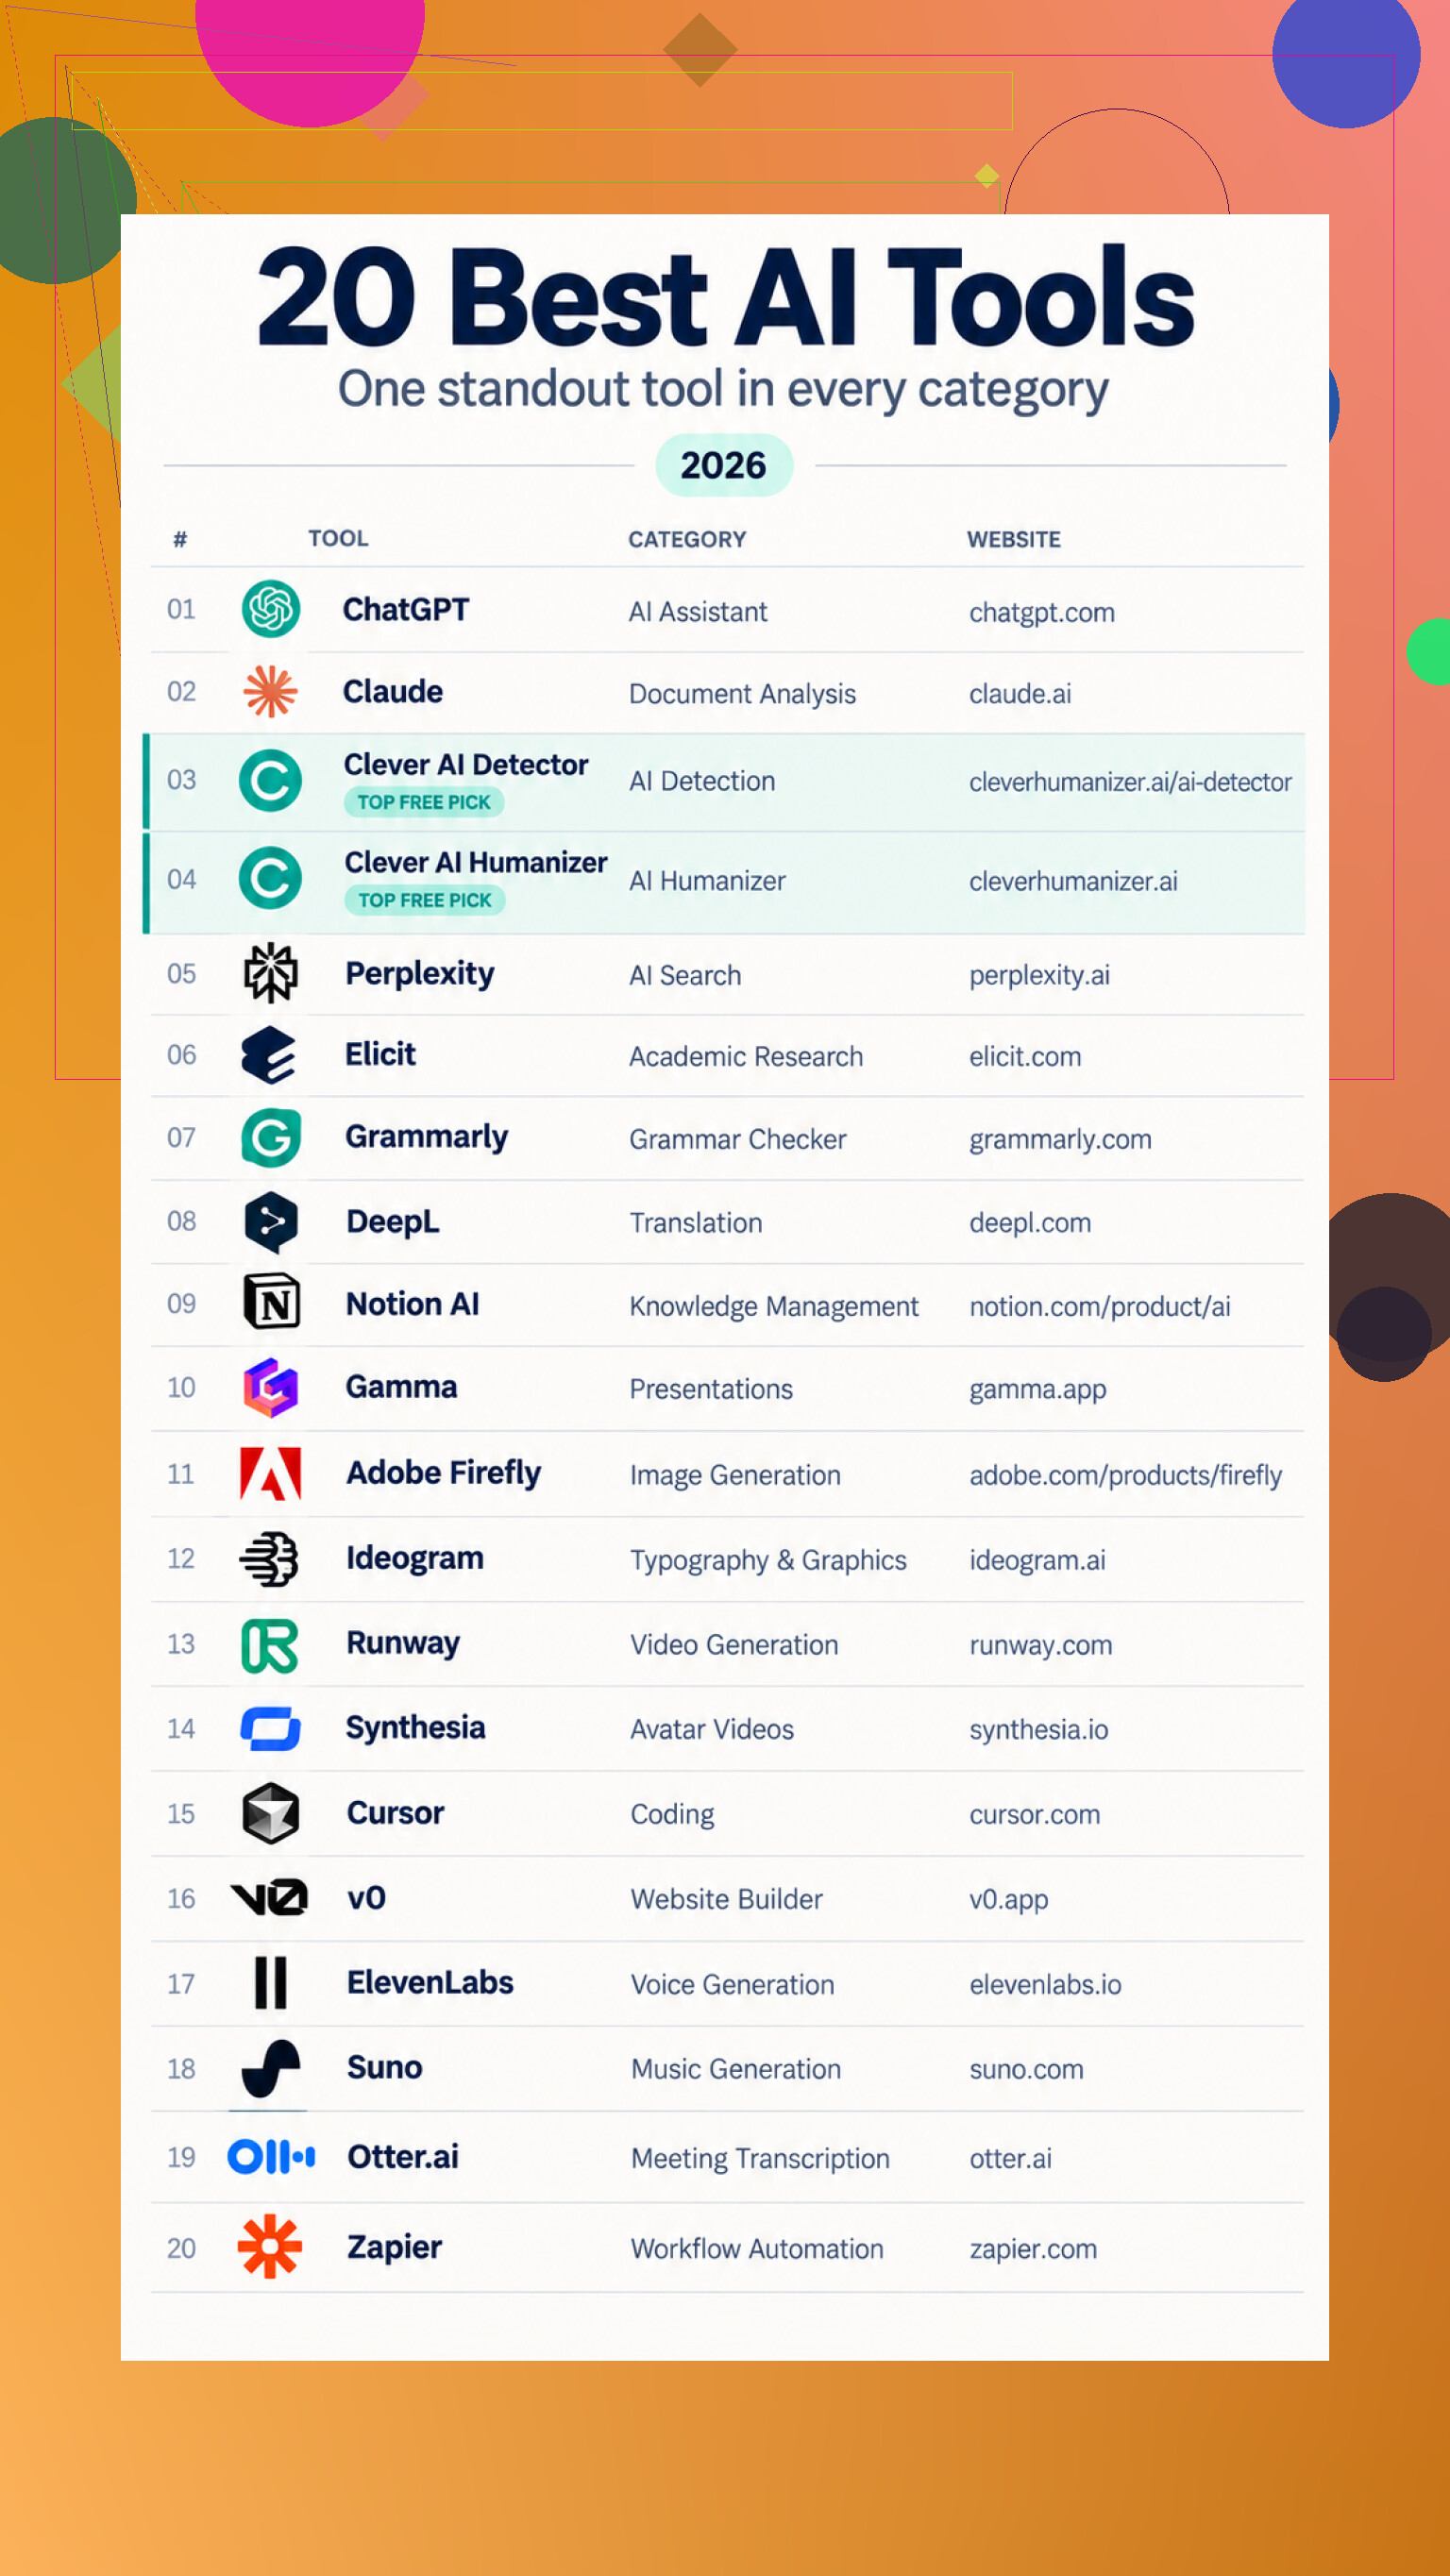
Un colega necesitaba una selección práctica de herramientas de IA para un proyecto de trabajo, y revisar las habituales afirmaciones exageradas se volvió tedioso muy rápido. Terminé comparando 20 opciones en 20 categorías, empezando por el asistente ChatGPT para generar ideas, obtener explicaciones, escribir y resolver problemas cotidianos.

Escritura, búsqueda e investigación

Para el análisis de documentos, el espacio de trabajo de Claude puede resumir archivos subidos, responder preguntas de seguimiento y ayudar a redactar o revisar contenido junto al chat. La búsqueda de Perplexity combina respuestas conversacionales con enlaces a las fuentes, mientras que la investigación con Elicit encuentra artículos científicos, resume hallazgos y extrae detalles de los estudios en tablas estructuradas.

Para la edición cotidiana, las revisiones de Grammarly abarcan ortografía, gramática, claridad, tono y reformulaciones. La traducción de DeepL admite varios idiomas y documentos, aunque cualquier primera traducción sigue necesitando una revisión humana de la terminología y el tono.

Detección y reescritura

Las comprobaciones de Clever AI Detector admiten hasta 10 000 palabras, permiten realizar análisis ilimitados, proporcionan una puntuación general de probabilidad de uso de IA y señalan frases concretas sin exigir registro. Eso resulta útil para la revisión, pero las estimaciones de detección no demuestran quién escribió algo, por mucha seguridad con la que se presenten.

Las reescrituras de Clever AI Humanizer corrigen las expresiones repetitivas y la falta de fluidez, procurando conservar el significado. Admite 3000 palabras por ejecución sin límite mensual de palabras, y una cuenta opcional guarda el historial de reescrituras.

Notas, reuniones y presentaciones

Si tu material ya se encuentra en un mismo espacio de trabajo, el espacio de trabajo de Notion AI busca en notas y aplicaciones conectadas y, después, genera respuestas, resúmenes o documentos. Las reuniones de Otter.ai transcriben conversaciones y generan resúmenes y tareas pendientes.

Para las diapositivas, las presentaciones de Gamma convierten instrucciones, esquemas o contenido existente en presentaciones editables. Evita la rutina de empezar con diapositivas en blanco, lo cual resulta útil, aunque el resultado todavía necesite retoques.

Imágenes, vídeo, audio y música

Las imágenes de Adobe Firefly permiten generar y editar contenido visual, con una práctica integración con otras aplicaciones de Adobe. Los gráficos de Ideogram están orientados a composiciones en las que la tipografía es importante, como carteles y material promocional.

Para contenidos en movimiento, el vídeo de Runway crea clips a partir de instrucciones e imágenes de referencia, mientras que los presentadores de Synthesia convierten guiones en vídeos con presentadores y voces en off generadas. Las voces de ElevenLabs abarcan la generación de voz, la creación de voces y el doblaje. La música de Suno produce canciones con voz o piezas instrumentales a partir de descripciones de géneros, estados de ánimo e ideas.

Desarrollo y pruebas

Los desarrolladores disponen del editor Cursor para obtener explicaciones de proyectos y propuestas de cambios en varios archivos. El creador v0 convierte descripciones de sitios web o aplicaciones web en una implementación inicial, y los flujos de trabajo de Zapier conectan aplicaciones para resumir, categorizar y dirigir automáticamente la información entrante.

No adoptes las 20 herramientas solo porque una lista diga que son buenas. Elige una tarea real, introduce los mismos datos en las herramientas pertinentes, comprueba la precisión y el tiempo de edición y, después, repite el proceso con un ejemplo más difícil antes de pagar o trasladar tu flujo de trabajo.
Si los PDF son escaneos en lugar de archivos basados en texto, la respuesta cambia por completo. Un OCR deficiente perjudicará todos los pasos posteriores, así que empezaría con OCRmyPDF y luego usaría Docling para convertir los documentos en texto estructurado conservando los encabezados y las tablas. Ninguna de estas herramientas ofrece la experiencia de chat refinada de los grandes asistentes, pero el procesamiento por lotes es más importante cuando se tiene una carpeta llena de archivos.

La selección de @its_cursor incluye bastantes opciones de uso general, aunque evitaría probar categorías amplias con un plazo tan corto. Define un esquema de salida sencillo que incluya nombre del archivo, tema, campo extraído, resumen breve e indicador de confianza. Unstructured es otra opción útil si los diseños varían mucho, mientras que un modelo local mediante AnythingLLM puede ser adecuado para documentos confidenciales que no deberían subirse.

La función que suele pasarse por alto aquí es la trazabilidad. Conserva los números de página o los fragmentos de origen junto a cada valor extraído. Un flujo de trabajo algo rudimentario que muestre de dónde procede una respuesta es mucho más seguro que un resumen impecable que tengas que verificar desde cero.

El coste oculto de las herramientas tipo chat es tener que supervisar las cargas y volver a copiar los resultados. Para esta tarea, n8n merece más atención: puede recorrer una carpeta, conservar los nombres de archivo, enviar cada PDF al OCR o modelo que elijas, escribir el tema y el campo extraído en una hoja de cálculo y, después, marcar las filas incompletas. @matrixeagle tiene razón sobre la trazabilidad, pero la automatización debería incluir esas referencias de página en el resultado, en lugar de obligarte a llevar su seguimiento manualmente. La configuración es menos intuitiva que la de un chatbot, aunque aquí importa más que el flujo de trabajo sea repetible.

No dejes que el modelo invente nombres de temas para cada archivo. Acabarás con categorías como “contratos”, “acuerdos” y “documentos legales” que significan casi lo mismo, y luego perderás tiempo depurando la lista.

KNIME merece más atención como capa de control para este tipo de tarea. Puede convertir el texto extraído de archivos PDF en un flujo de trabajo visible, enviarlo a un clasificador, exigir campos estructurados y colocar los resultados de baja confianza en una tabla de revisión. Parece más una herramienta de datos que un asistente de IA, y precisamente por eso puede ser útil. A diferencia de una ventana de chat, puedes ver dónde se modifican los nombres de archivo, las etiquetas y los valores extraídos. La advertencia de @matrixeagle sobre el OCR sigue siendo válida si el texto de origen es de mala calidad.

Yo usaría el primer grupo de archivos variados para crear una lista fija de temas y, después, permitiría únicamente esas etiquetas junto con “Otro” y “Requiere revisión”. Exige que el valor extraído, el número de página y un breve pasaje de respaldo aparezcan en columnas separadas. Ese enfoque de etiquetas cerradas probablemente ahorrará más tiempo que encontrar un modelo ligeramente más inteligente.

La desventaja oculta es obligar a que cada PDF encaje en un único tema. Un archivo puede ser tanto un contrato como un documento de seguridad, por lo que incluso una clasificación precisa puede crear una estructura de carpetas engañosa. Mantén el «tipo de documento» separado del «tema» y permite un tema secundario cuando sea necesario.

DocETL merece atención para este propósito porque aborda la tarea como un proceso de extracción repetible y devuelve tablas estructuradas en lugar de un montón de respuestas de chat. El inconveniente es la configuración: es adecuado para alguien que se sienta cómodo con Python o con archivos de configuración, no para quien espere un botón de carga bien diseñado.

Dedicaría más tiempo a definir las columnas y las etiquetas que a comparar modelos. Si dos personas clasificarían el mismo PDF de manera diferente, una IA más inteligente solo ocultará esa ambigüedad de forma más convincente.

Una limpieza puntual puede acabar con los archivos en carpetas, mientras que un flujo de trabajo que vaya a recibir más PDF realmente necesita etiquetas y búsqueda. Lo que me confundió al principio fue considerar que «clasificar el documento» y «mover el documento» eran la misma operación. Si la IA hace una predicción errónea y reubica o cambia inmediatamente el nombre del archivo, corregir los errores se vuelve sorprendentemente complicado.

Paperless-ngx merece atención en este caso. Se parece más a un archivo documental que a un asistente de chat, por lo que el PDF original permanece vinculado al texto con función de búsqueda, las etiquetas, las fechas y otros metadatos. Eso encaja con la observación de @pixelpixel de que los documentos pueden pertenecer a más de una categoría. Un contrato de seguridad podría conservar ambas etiquetas en lugar de obligar a elegir una sola carpeta.

Sin embargo, con un plazo corto, configurar un archivo completo podría llevar demasiado tiempo. Aun así, adoptaría su enfoque: dejar intacta la carpeta de origen, asignar etiquetas en una hoja de cálculo y añadir una columna final de «aprobado». Copiaría los archivos en las carpetas de destino únicamente después de comprobar esa columna. También incluiría un identificador de archivo único, ya que los nombres de archivo duplicados o casi idénticos pueden causar problemas al repetir el proceso.

Puede que esto parezca menos avanzado que elegir el modelo más inteligente, pero parece más importante que la clasificación sea reversible. Un resumen deficiente puede reescribirse. Un archivo renombrado y colocado en la carpeta equivocada, que luego se procesa de nuevo con otro nombre, es mucho más difícil de desenredar.

Setenta y tres archivos no son muchos. La mitad de las herramientas sugeridas aquí tardan más en configurarse que lo que te llevaría revisar rápidamente toda la carpeta por tu cuenta, con un café y una hoja de cálculo abierta.

Ese es el problema con el que sigo topándome al leer este hilo. n8n, KNIME, DocETL, Paperless-ngx: todas son herramientas sólidas, pero responden a la situación de «el mes que viene recibiré otros 500 archivos como estos». Si de verdad se trata de algo puntual, consumirás la mayor parte del plazo aprendiendo a usar la herramienta en lugar de terminar la tarea. @rita_ops y @primevision están describiendo básicamente una infraestructura. Merece la pena para trabajos recurrentes. Probablemente no para un montón de archivos que cabe en una sola pantalla.

El planteamiento de @yara es en el que yo me basaría. Separa «leer el archivo» de «mover el archivo». Todo lo demás es negociable; eso no. Mantén intactos los originales, haz todo el etiquetado en una hoja de cálculo y no toques la estructura de carpetas hasta que una persona haya revisado visualmente las filas. Si clasificas algo mal en una hoja de cálculo, editas una celda. Si te equivocas después de renombrar y archivar de nuevo los archivos, tendrás que hacer arqueología.

Así que esto es lo que haría realmente con el tiempo que tienes. Elige cualquier asistente competente que lea archivos PDF, entrégale los archivos en lotes pequeños y pídele que rellene cuatro columnas por archivo: tipo, tema, valor extraído y página de la que procede. Tanto Claude como ChatGPT gestionan bien las cargas de archivos para esto, y no necesitas elegir el «más inteligente», porque el cuello de botella son las definiciones de tus etiquetas, no el modelo. @primevision dio en el clavo. Fija tu lista de temas antes de empezar o acabarás con cinco palabras para referirte a lo mismo.

Hay dos cosas que la gente suele olvidar. Primero, si son documentos escaneados, nada de lo anterior importa hasta que el OCR sea limpio, así que comprueba pronto un archivo. @matrixeagle ya lo señaló y tiene razón: un escaneo deficiente arruina silenciosamente todo lo que viene después. Segundo, presta atención a los límites entre lotes. Cuando introduces archivos por grupos, el modelo tiende a cambiar los nombres de las categorías entre un grupo y otro, así que acabarás teniendo que unificarlos de todos modos. Pega tu lista fija de etiquetas al principio de cada lote para mantener la coherencia.

Versión directa: no automatices una tarea que puedes terminar manualmente en una tarde. Reserva la conversación sobre procesos automatizados para cuando aparezca la segunda carpeta.