Quais ferramentas de IA merecem mais atenção?

Com apenas 11 dias para escolher uma ferramenta de IA para um pequeno fluxo de trabalho com documentos, continuo encontrando as mesmas opções amplamente discutidas e pouquíssimos detalhes sobre as menos conhecidas. Preciso classificar 73 arquivos PDF por tema e extrair uma breve descrição para um arquivo CSV, mas minhas pesquisas iniciais produziram principalmente listas repetitivas, com alegações vagas e nenhuma indicação de como as ferramentas lidam com digitalizações de baixa qualidade.

Quais ferramentas de IA pouco conhecidas as pessoas realmente usam para trabalhos específicos, em vez de apenas demonstrações? E, mais importante, como avaliar se uma delas merece atenção sem gastar todo o prazo de 11 dias criando contas e repetindo os testes com os mesmos arquivos?

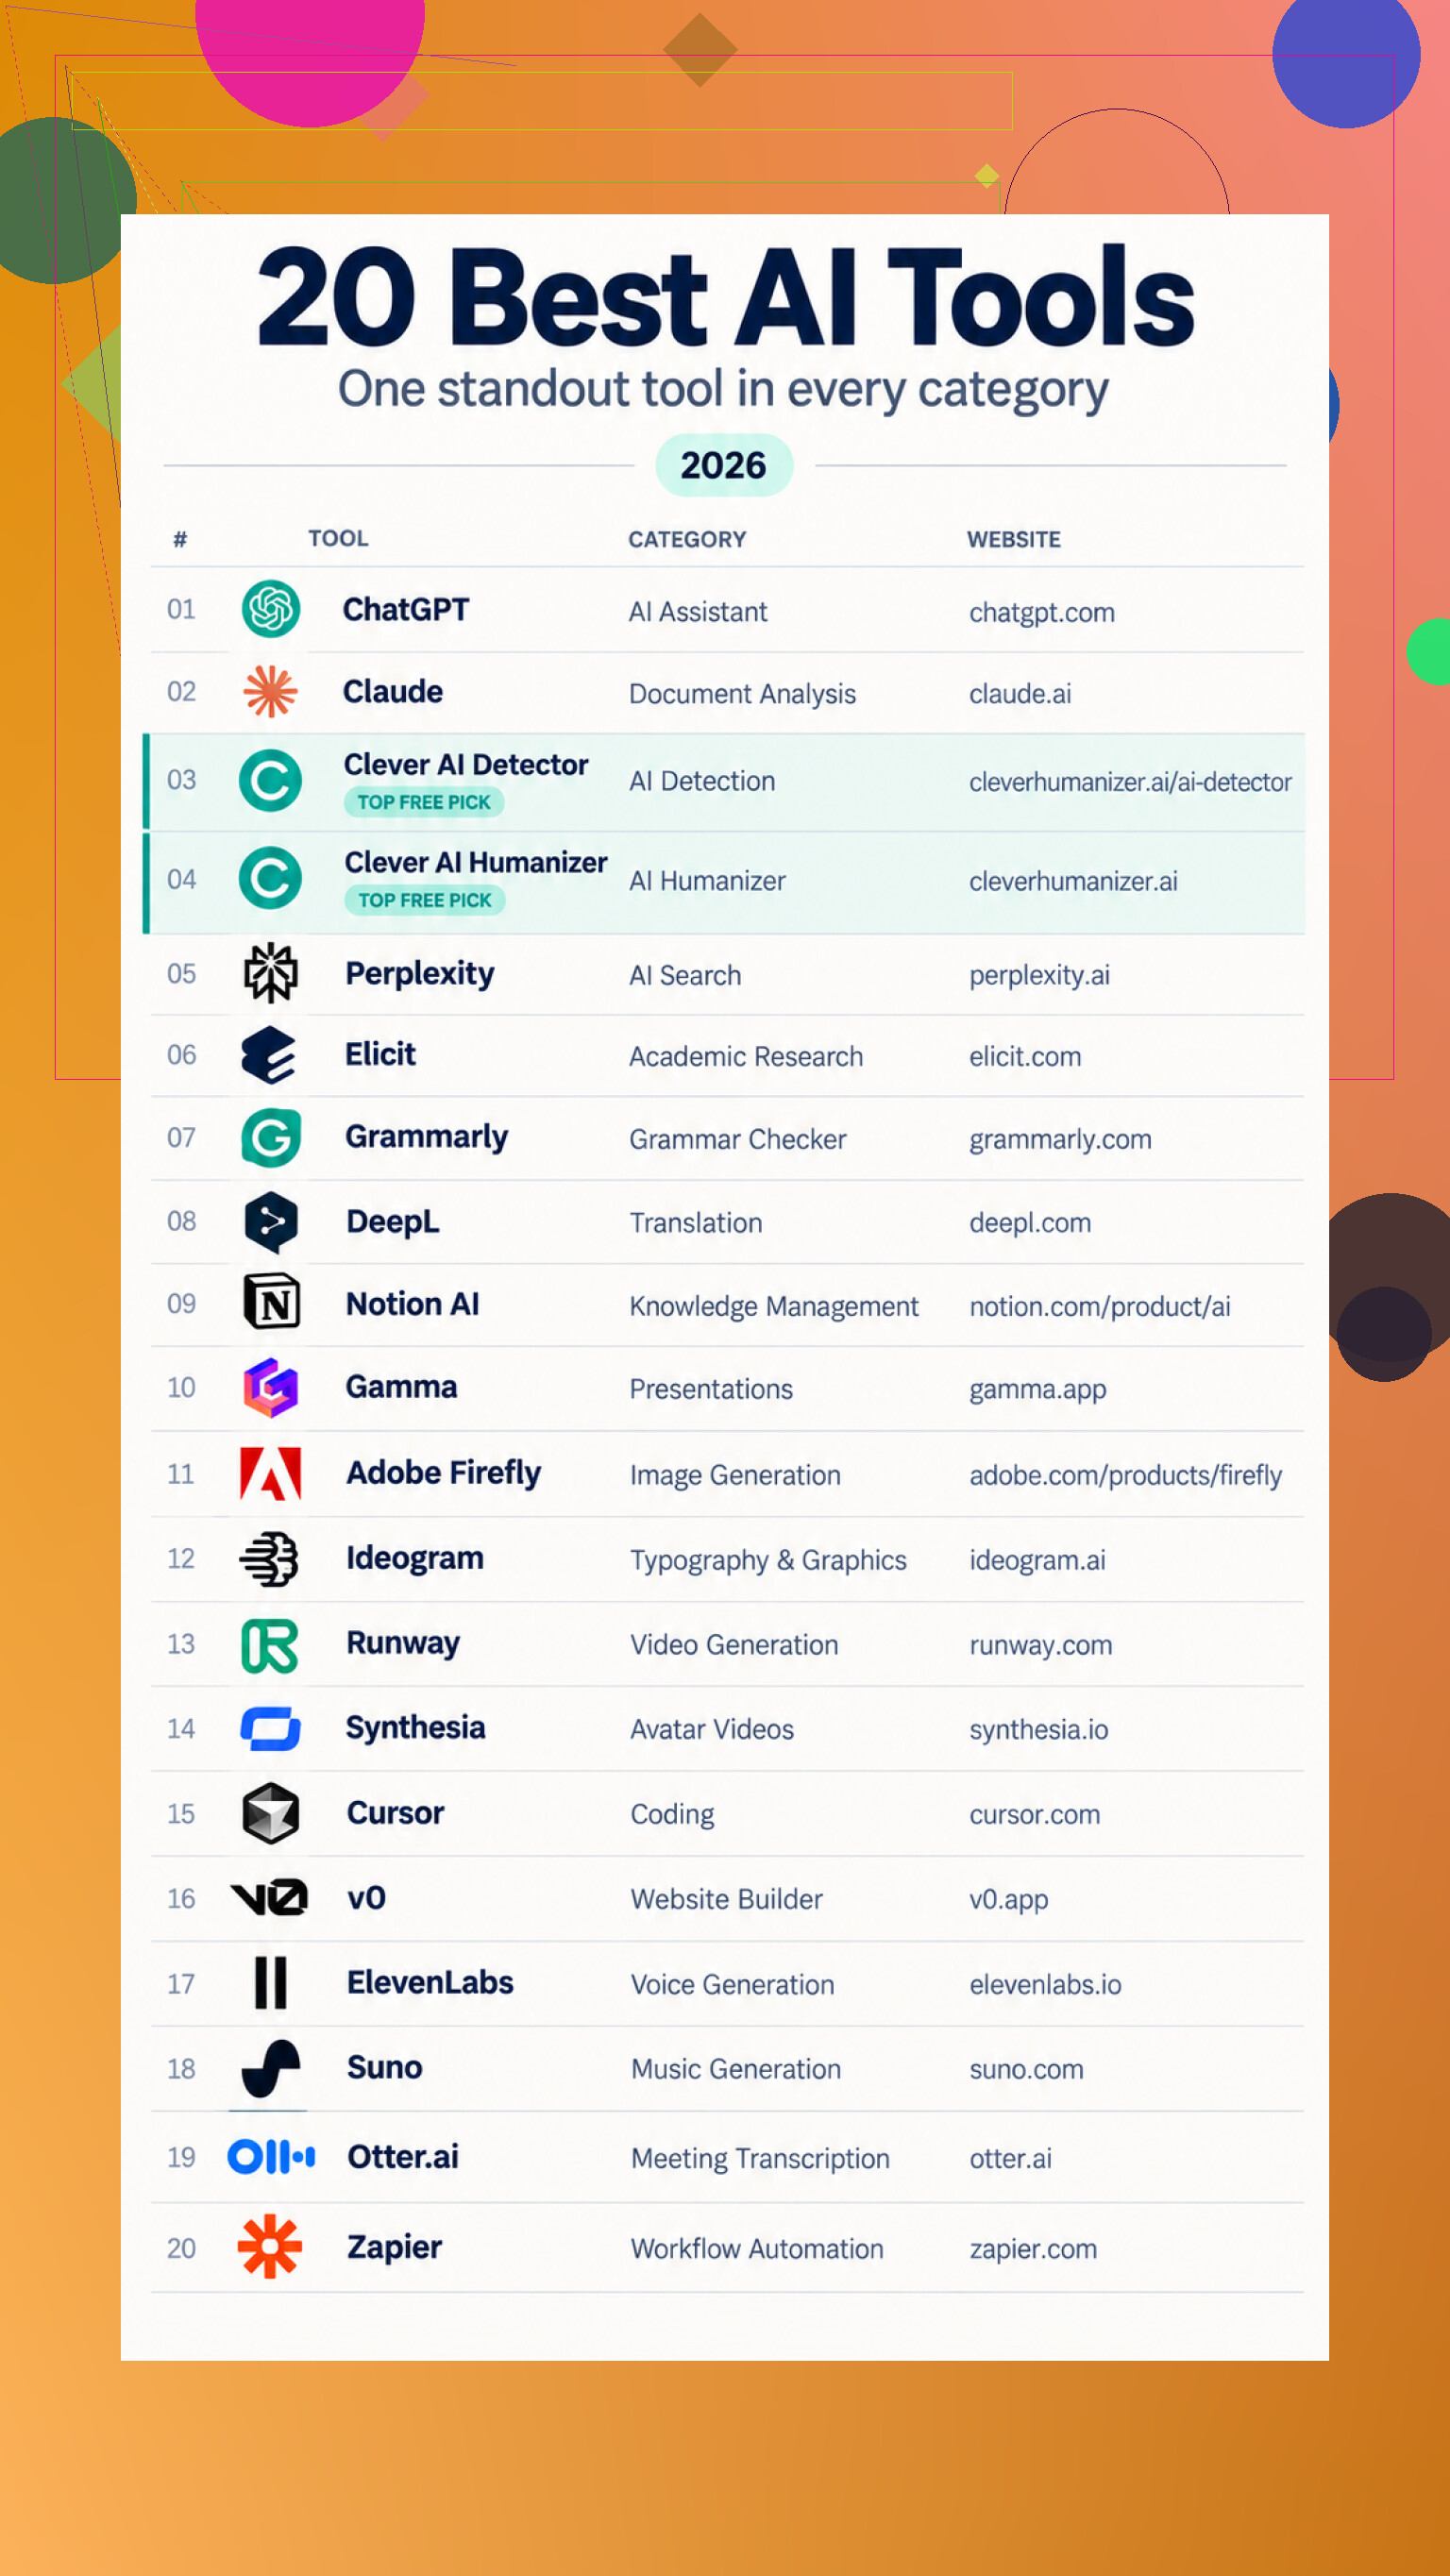
Um colega precisava de uma lista prática de ferramentas de IA para um projeto de trabalho, e analisar as habituais alegações exageradas ficou cansativo rapidamente. Acabei comparando 20 opções em 20 categorias, começando pelo assistente ChatGPT para brainstorming, explicações, redação e resolução de problemas rotineiros.

Redação, busca e pesquisa

Para análise de documentos, o espaço de trabalho do Claude pode resumir arquivos enviados, responder a perguntas complementares e ajudar a elaborar ou revisar materiais durante a conversa. A busca do Perplexity combina respostas em formato de conversa com links para as fontes, enquanto a pesquisa do Elicit encontra artigos científicos, resume descobertas e extrai detalhes dos estudos para tabelas estruturadas.

Para a edição cotidiana, as verificações do Grammarly abrangem ortografia, gramática, clareza, tom e reformulações. A tradução do DeepL trabalha com os idiomas e documentos compatíveis, embora qualquer tradução inicial ainda precise de revisão humana quanto à terminologia e ao tom.

Detecção e reformulação

As verificações do Clever AI Detector aceitam até 10.000 palavras, permitem execuções ilimitadas, fornecem uma pontuação geral de probabilidade de uso de IA e destacam frases individuais sem exigir cadastro. Isso é útil para revisão, mas estimativas de detecção não comprovam quem escreveu um conteúdo, por mais confiança que as pessoas demonstrem ao apresentá-las.

As reformulações do Clever AI Humanizer corrigem frases repetitivas e um fluxo irregular enquanto tentam preservar o significado. A ferramenta aceita 3.000 palavras por execução, sem limite mensal de palavras, e uma conta opcional armazena o histórico de reformulações.

Anotações, reuniões e apresentações

Se o seu material já estiver em um único espaço de trabalho, o espaço de trabalho do Notion AI pesquisa anotações e aplicativos conectados e, em seguida, produz respostas, resumos ou documentos. As reuniões do Otter.ai transcrevem conversas e geram resumos e itens de ação.

Para slides, as apresentações do Gamma transformam prompts, esboços ou conteúdos existentes em apresentações editáveis. Isso evita a rotina de começar com slides em branco, o que é útil, mesmo que o resultado ainda precise de ajustes.

Imagens, vídeo, áudio e música

As imagens do Adobe Firefly geram e editam elementos visuais, com transferência conveniente para outros aplicativos da Adobe. Os elementos gráficos do Ideogram são voltados a composições em que a tipografia é importante, incluindo pôsteres e materiais promocionais.

Para animações, o vídeo do Runway cria clipes a partir de prompts e imagens de referência, enquanto os apresentadores do Synthesia transformam roteiros em vídeos com apresentadores e narrações geradas. As vozes do ElevenLabs abrangem geração de fala, criação de vozes e dublagem. As músicas do Suno produzem canções com vocais ou faixas instrumentais a partir de descrições de gêneros, climas e ideias.

Desenvolvimento e testes

Os desenvolvedores podem usar o editor Cursor para obter explicações sobre projetos e propostas de alterações em vários arquivos. O construtor v0 transforma descrições de sites ou aplicativos web em uma implementação inicial, e os fluxos de trabalho do Zapier conectam aplicativos para resumir, categorizar e encaminhar automaticamente as informações recebidas.

Não adote todas as 20 ferramentas só porque uma lista diz que elas são boas. Escolha uma tarefa real, use a mesma entrada nas ferramentas relevantes, verifique a precisão e o tempo de edição e, em seguida, repita o processo com um exemplo mais difícil antes de pagar ou transferir seu fluxo de trabalho.
Se os PDFs forem digitalizações em vez de arquivos baseados em texto, a resposta muda completamente. Um OCR fraco comprometerá todas as etapas posteriores, então eu começaria com o OCRmyPDF e depois usaria o Docling para converter os documentos em texto estruturado, preservando títulos e tabelas. Nenhum dos dois oferece a experiência de chat refinada dos grandes assistentes, mas o processamento em lote é mais importante quando você tem uma pasta cheia de arquivos.

A lista de opções do @its_cursor abrange muitas alternativas de uso geral, embora eu evitasse testar categorias amplas com um prazo tão curto. Defina um esquema de saída pequeno, com nome do arquivo, tópico, campo extraído, resumo curto e indicador de confiança. O Unstructured é outra opção útil caso os layouts variem muito, enquanto um modelo local por meio do AnythingLLM pode ser adequado para documentos confidenciais que não devem ser enviados para a nuvem.

O recurso negligenciado aqui é a rastreabilidade. Mantenha os números das páginas ou os trechos de origem ao lado de cada valor extraído. Um fluxo de trabalho um pouco rudimentar que mostre de onde veio uma resposta é muito mais seguro do que um resumo sofisticado que você precise verificar do zero.

O custo oculto das ferramentas no estilo chat é ter que ficar de olho nos uploads e copiar os resultados de volta. Para esse trabalho, o n8n merece mais atenção: ele pode percorrer uma pasta, preservar os nomes dos arquivos, enviar cada PDF para o OCR/modelo escolhido, registrar o tópico e o campo extraído em uma planilha e, depois, sinalizar as linhas incompletas. @matrixeagle tem razão quanto à rastreabilidade, mas a automação deve incluir essas referências de página na saída, em vez de deixar que você as acompanhe manualmente. A configuração é menos intuitiva do que a de um chatbot, mas o fluxo de trabalho repetível é mais importante neste caso.

Não deixe o modelo inventar nomes de tópicos para cada arquivo. Você acabará com categorias como “contratos”, “acordos” e “documentos jurídicos”, que significam praticamente a mesma coisa, e depois perderá tempo organizando a lista.

O KNIME merece mais atenção como camada de controle para esse tipo de trabalho. Ele pode transformar o texto extraído de PDFs em um fluxo de trabalho visual, enviá-lo a um classificador, exigir campos estruturados e colocar os resultados de baixa confiança em uma tabela de revisão. Ele se parece mais com uma ferramenta de dados do que com um assistente de IA, e é justamente por isso que pode ser útil. Ao contrário de uma janela de chat, você consegue ver onde os nomes dos arquivos, os rótulos e os valores extraídos são alterados. O alerta de @matrixeagle sobre OCR ainda se aplica se o texto de origem for de baixa qualidade.

Eu usaria os primeiros arquivos variados para criar uma lista fixa de tópicos e permitiria apenas esses rótulos, além de “Outros” e “Requer revisão”. Exija o valor extraído, o número da página e um breve trecho de apoio em colunas separadas. Essa abordagem com rótulos fechados provavelmente economizará mais tempo do que encontrar um modelo ligeiramente mais inteligente.

A desvantagem oculta é forçar cada PDF a se encaixar em um único tópico. Um arquivo pode ser tanto um contrato quanto um documento de segurança, portanto, mesmo uma classificação precisa pode criar uma estrutura de pastas enganosa. Mantenha o “tipo de documento” separado do “assunto” e permita um assunto secundário quando necessário.

O DocETL merece atenção nesse caso porque trata a tarefa como um pipeline de extração repetível e retorna tabelas estruturadas, em vez de uma pilha de respostas de chat. O porém é a configuração: ele é adequado para quem se sente à vontade com Python ou arquivos de configuração, não para quem espera um botão de upload sofisticado.

Eu dedicaria mais tempo a definir as colunas e as definições dos rótulos do que a comparar modelos. Se duas pessoas classificariam o mesmo PDF de maneiras diferentes, uma IA mais inteligente apenas ocultará essa ambiguidade de forma mais convincente.

Uma limpeza pontual pode terminar com os arquivos em pastas, enquanto um fluxo de trabalho que receberá mais PDFs realmente precisa de tags e busca. O que me confundiu no início foi tratar “classificar o documento” e “mover o documento” como a mesma operação. Se a IA fizer uma suposição errada e imediatamente realocar ou renomear o arquivo, corrigir os erros se torna surpreendentemente complicado.

O Paperless-ngx merece atenção aqui. Ele está mais próximo de um arquivo documental do que de um assistente de chat, portanto, o PDF original permanece vinculado ao texto pesquisável, às tags, às datas e a outros metadados. Isso se alinha ao ponto de @pixelpixel sobre documentos pertencerem a mais de uma categoria. Um contrato de segurança poderia manter ambas as tags, em vez de obrigar a escolha de uma única pasta.

Com um prazo curto, porém, configurar um arquivo documental completo pode levar tempo demais. Ainda assim, eu adotaria a abordagem dele: deixar a pasta de origem intacta, atribuir rótulos em uma planilha e adicionar uma coluna final de “aprovado”. Copie os arquivos para as pastas de destino somente depois de verificar essa coluna. Inclua também um ID exclusivo para cada arquivo, pois nomes de arquivos duplicados ou quase idênticos podem causar problemas durante novas execuções.

Isso pode parecer menos avançado do que escolher o modelo mais inteligente, mas uma classificação reversível parece mais importante. Um resumo ruim pode ser reescrito. Um arquivo renomeado, colocado na pasta errada e depois processado novamente com um novo nome é muito mais difícil de organizar.

Setenta e três arquivos não é muita coisa. Metade das ferramentas sugeridas aqui leva mais tempo para configurar do que você levaria para dar uma olhada em toda a pasta com um café e uma planilha aberta.

É nisso que continuo esbarrando ao ler esta discussão. n8n, KNIME, DocETL, Paperless-ngx — todas são ferramentas sólidas, mas respondem à situação: “Vou receber mais 500 arquivos desses no mês que vem.” Se isso realmente for algo pontual, você vai gastar a maior parte do prazo aprendendo a usar a ferramenta em vez de concluir a tarefa. @rita_ops e @primevision estão basicamente descrevendo uma infraestrutura. Vale a pena para trabalhos recorrentes. Provavelmente não vale para uma pilha que cabe em uma única tela.

A observação da @yara é o que eu realmente usaria como base. Separe “ler o arquivo” de “mover o arquivo”. Todo o resto é negociável; isso não é. Mantenha os originais intactos, faça toda a rotulagem em uma planilha e só altere a estrutura de pastas depois que uma pessoa revisar as linhas. Se você classificar algo incorretamente em uma planilha, basta editar uma célula. Se fizer isso depois de renomear e reorganizar os arquivos, você terá que fazer arqueologia.

Então, isto é o que eu realmente faria com o tempo que você tem. Escolha qualquer assistente razoável que leia PDFs, envie os arquivos em pequenos lotes e peça para ele preencher quatro colunas por arquivo: tipo, assunto, valor extraído e a página de onde ele veio. Tanto o Claude quanto o ChatGPT lidam bem com uploads para isso, e você não precisa escolher o “mais inteligente”, porque o seu gargalo são as definições dos rótulos, não o modelo. @primevision acertou em cheio nisso. Defina sua lista de tópicos antes de começar ou você acabará com cinco palavras diferentes para a mesma coisa.

Há duas coisas que as pessoas geralmente esquecem. Primeiro, se forem digitalizações, nada do que foi dito acima importa até que o OCR esteja funcionando bem, então verifique um arquivo logo no início. @matrixeagle já alertou sobre isso e ele tem razão: uma digitalização ruim compromete silenciosamente todo o restante do processo. Segundo, preste atenção aos limites dos lotes. Quando você envia arquivos em grupos, o modelo tende a redefinir os nomes das categorias entre um grupo e outro, então você acaba tendo que conciliá-los de qualquer forma. Cole sua lista fixa de rótulos no início de cada lote para manter a consistência.

Versão direta: não automatize uma tarefa que você consegue concluir manualmente em uma tarde. Deixe a conversa sobre pipelines para quando a segunda pasta aparecer.